一次血浆蛋白检测,读到的究竟是疾病信号,还是年龄、青春期、体重和遗传背景留下的"底色"?Matthias Mann、Torben Hansen 等团队在《Nature Genetics》发表的大规模儿童血浆蛋白组学研究给出了更准确的答案:在 1216 种通过质控的蛋白中,58% 与年龄、性别或 BMI 相关;把遗传因素也纳入后,约 70% 的蛋白受到至少一种因素影响。对标志物开发来说,真正重要的不是某个蛋白"变了",而是它为什么变。
一份儿童检测结果,为什么不能只对照成人参考值?
检验单上的"参考范围",很容易让人产生一种直觉:蛋白水平应该像刻度尺一样稳定,超出范围才意味着异常。
但对儿童和青少年来说,身体本身就在快速变化。生长、青春期发育、激素波动、骨骼成熟、免疫系统变化以及体重状态,都可能同步改写血浆蛋白水平。同一个蛋白,在 8 岁、13 岁和 18 岁时,可能对应完全不同的生理背景。
如果忽略这些差异,研究者可能把正常发育误判为疾病信号,也可能把遗传造成的稳定差异,当成治疗或病程带来的变化。
这正是 Mann 团队这项研究最值得关注的地方:它不是只寻找"哪些蛋白有差异",而是试图为儿童血浆蛋白组建立一张动态地图。
这项研究,究竟做了多大规模?
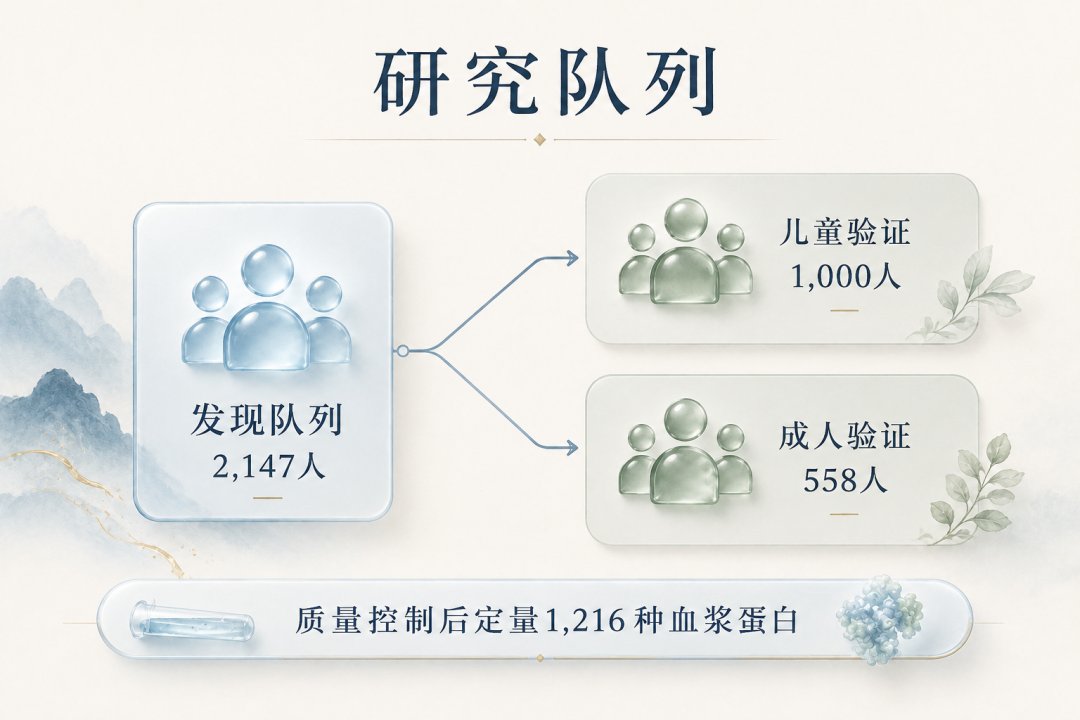
研究的发现队列来自丹麦 HOLBAEK 研究,共纳入 2147 名 5—20 岁的儿童和青少年,其中既包括普通人群,也包括儿童肥胖门诊人群。
研究者采用基于质谱的血浆蛋白质组学流程,在质量控制后定量到 1216 种蛋白;同时分析 520 万个 SNP,并结合年龄、性别、BMI 标准差评分、肥胖状态、青春期状态和样本储存时间等信息。
为了验证结果,团队又使用了两组独立样本:1000 名儿童和青少年,以及 558 名成人酒精相关肝病队列参与者。也就是说,这项工作不仅观察儿童内部的差异,还进一步追问:儿童期看到的遗传效应,到了成年后是否仍然存在。
先看最直观的发现:发育本身就在改写蛋白组
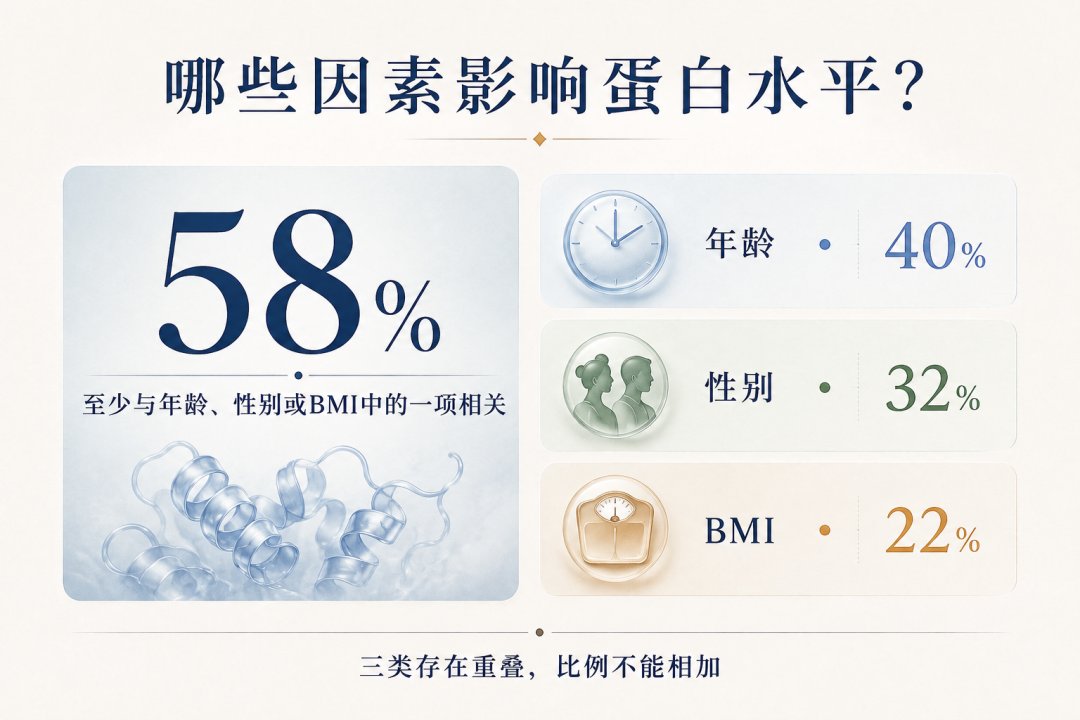
正式发表版数据显示,在 1216 种蛋白中,58% 至少与年龄、性别或 BMI 标准差评分中的一项相关。其中,40% 与年龄相关,32% 与性别相关,22% 与 BMI 相关,还有 8% 同时与三项因素相关。
这些数字不能简单相加,因为同一个蛋白可能同时受到多种因素影响。它们共同说明:儿童血浆蛋白组不是一张静态照片,而是一段随发育不断变化的"分子影像"。
例如,IGF1 在女孩 12—13 岁、男孩 14—15 岁左右达到峰值后下降;ACAN、COL1A1、COL1A2、COMP 等与骨骼和软骨发育相关的蛋白,在青春期后出现下降,并呈现性别相关的时间差异。
与肥胖相关的变化也不只出现在传统炎症指标上。脂联素、CRP、SHBG、IGFBP1、IGFBP2 等蛋白呈现出体重状态相关差异,研究还发现了一批此前较少与儿童肥胖联系起来的候选蛋白。
50 个蛋白,能把年龄估到多接近?
研究者进一步把问题反过来:既然蛋白组会随发育变化,那么能否根据蛋白水平推测年龄和 BMI?
在未参与模型训练的 639 人测试集中,由 50 种蛋白组成的模型预测年龄时,平均绝对误差约为 1.2 年,预测值与实际年龄的相关系数为 0.85。只使用排名前 5—10 的蛋白,平均误差也约为 1.5—1.6 年。
这并不意味着一次抽血就能判断孩子"发育是否正常",也不等于可以直接用于临床诊断。它更像一个概念验证:血浆蛋白确实记录了生长发育的系统性轨迹,因此在儿童队列中建立年龄分层参考值,是标志物研究不可省略的一步。
影响蛋白的不只有成长,还有写在基因里的差异
在 1909 名同时具备蛋白组、基因型和协变量数据的参与者中,研究团队检验了 520 万个 SNP 与 1216 种蛋白水平之间的关系。
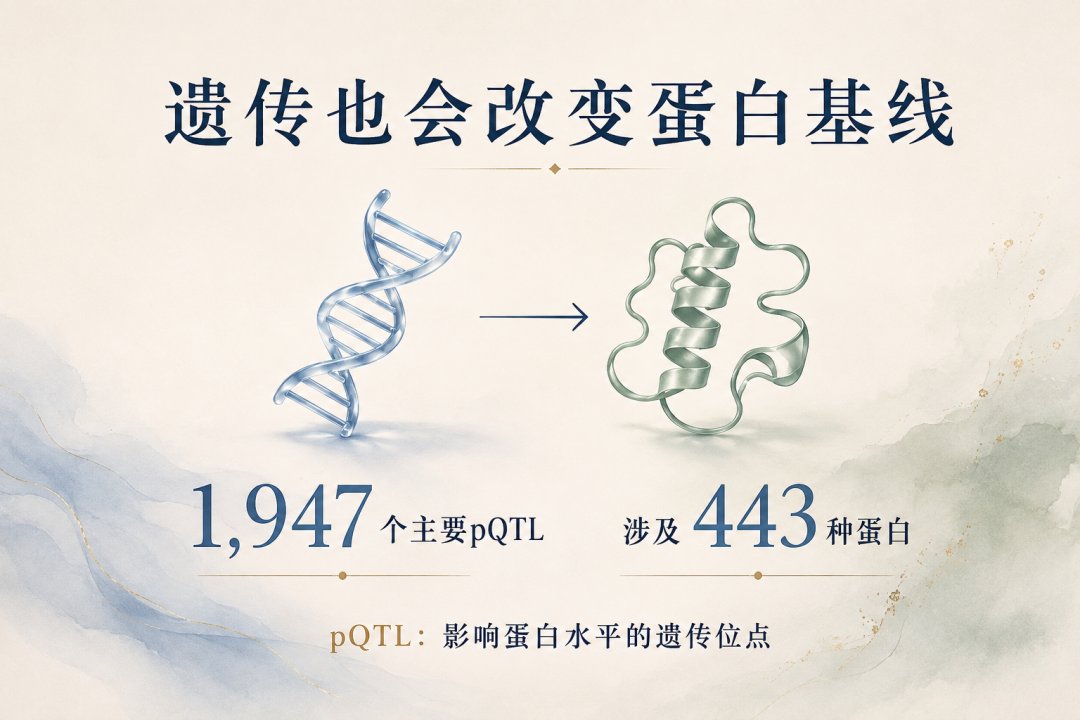
采用常规全基因组显著性阈值时,研究鉴定出 1947 个主要 pQTL,涉及 443 种蛋白;进一步进行条件分析后,得到 733 个条件独立 pQTL。研究中 62% 的 pQTL 属于顺式调控,即位于相应蛋白编码基因附近。
pQTL 可以理解为"会影响蛋白水平的遗传位点"。对某些蛋白而言,不同基因型之间的差别并不小:143 个 pQTL 对应 71 种蛋白,其纯合基因型之间的蛋白水平差异超过 2 倍;个别效应可达到数十倍。
这会直接影响标志物解释。如果一种候选蛋白本来就被遗传背景强烈调控,那么病例组与对照组之间的差异,可能有一部分来自基因频率,而不是疾病本身。
这些遗传效应,会随着长大而消失吗?
研究把儿童发现队列按 5—9 岁、10—14 岁和 15—20 岁分组,遗传效应在三个年龄段之间保持了很高的一致性,相关系数为 0.95—0.98。
在独立验证中,可验证的 pQTL 有 97% 在 1000 名儿童和青少年中复现,91% 在 558 名成人中复现;发现队列与验证队列的效应方向和大小也高度一致,相关系数分别达到 0.97 和 0.98。
这意味着,许多从儿童期开始影响蛋白水平的遗传效应,并不会在成年后轻易消失。对需要跨年龄随访的队列研究而言,pQTL 不是可以忽略的背景噪声,而是应提前纳入设计与统计模型的基础变量。
为什么这对生物标志物开发格外重要?
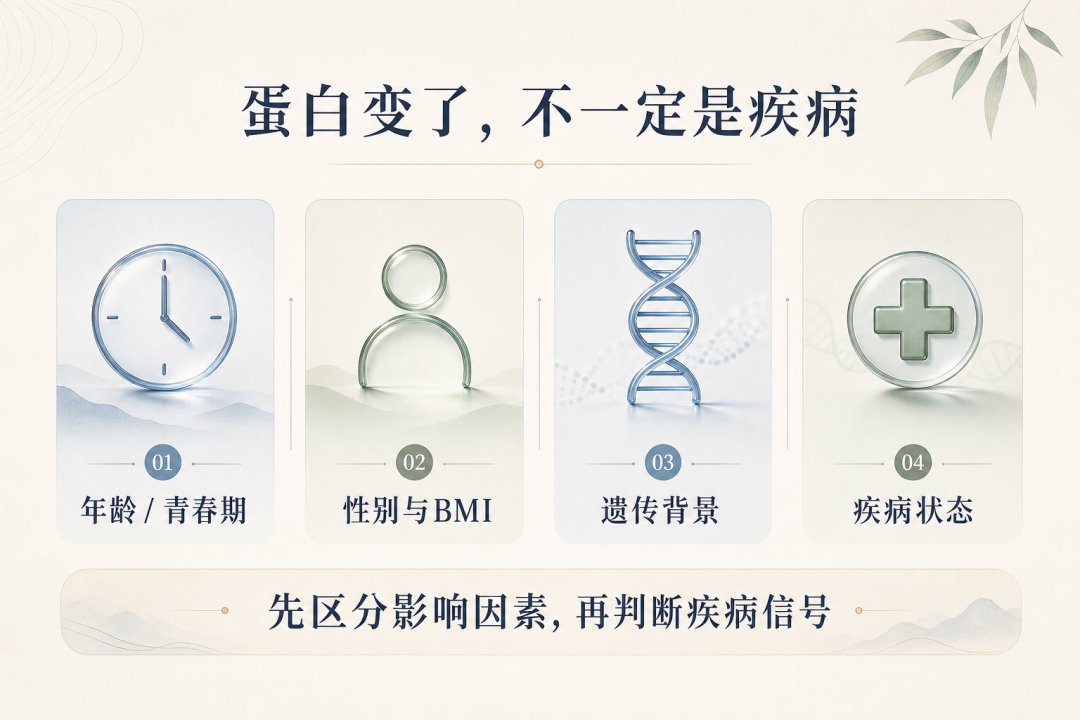
一个蛋白在病例组升高,并不自动等于"它是疾病标志物"。研究者至少要同时问四个问题:它是否随年龄变化?是否存在性别差异?是否受到 BMI 或肥胖状态影响?是否被某个 pQTL 强烈调控?
Mann 团队的方差分解显示,在具有 pQTL 的蛋白中,63% 的蛋白由 pQTL 解释的方差,高于年龄、性别、BMI 和肥胖状态合计解释的方差。换句话说,对一部分蛋白而言,遗传背景甚至比常见人口学因素更能决定其基础水平。
论文进一步把高置信度 pQTL 与心代谢相关 GWAS 数据结合。孟德尔随机化分析得到 345 组蛋白—性状关系,其中 101 组关系同时获得共定位分析支持,涉及 41 个基因和 33 项性状。
这些结果为疾病机制和药物靶点研究提供了线索,但仍应理解为遗传证据支持的潜在因果关系,而不是对药物有效性或临床用途的直接证明。
一处必须纠正的数字:为什么不是"90% 受非遗传因素影响"?
围绕这项研究的部分二次传播使用了"90% 的蛋白受年龄、性别或 BMI 影响"的说法。这个数字来自较早阶段的表述,容易把不同统计口径混在一起。
按照 2025 年正式发表的论文正文,年龄、性别和 BMI 三类因素合计关联的是 58% 的蛋白;把遗传变异也纳入后,约 70% 的蛋白受到至少一种因素影响。论文中另一个约 90% 的数字,是"约 90% 的 pQTL 满足独立队列验证条件",并不是非遗传因素影响的蛋白比例。
对科普和产品传播来说,统计口径比数字大小更重要。把 58%、70% 和 90% 各自对应的对象说清楚,才能避免一个醒目的标题掩盖真正的科学结论。
论文说明了什么,也没有说明什么?
第一,这是一项横断面研究。它描绘了不同年龄人群之间的蛋白轨迹,但不能完全替代对同一批儿童进行多年纵向随访。
第二,研究主要来自丹麦人群。相对同质的人群有利于减少群体分层干扰,但结果仍需要在更多祖源和生活环境中验证。
第三,5 岁和 20 岁两个年龄端的样本相对较少,年龄轨迹在这些位置的不确定性更高。
第四,研究定量到 1216 种通过质控的蛋白,这是特定样本处理、仪器平台、检测深度和队列规模共同作用的结果,不能直接与其他平台的"检出蛋白数"做简单高低比较。
最重要的是,这项研究建立的是儿童血浆蛋白组的参考资源,并没有推出可用于个体诊断的"儿童蛋白年龄检测"。
从一篇论文走到一个可靠标志物项目,需要做对哪些事?
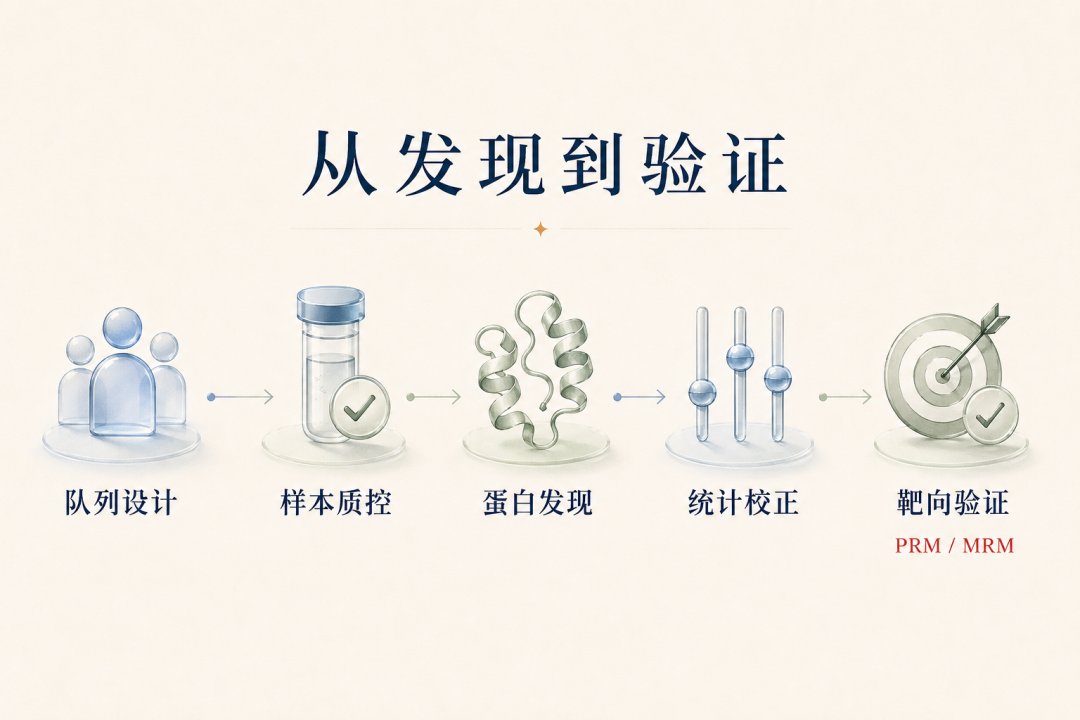
第一步,是把队列设计放在检测之前。年龄分层、性别比例、BMI 分布、青春期状态、用药和合并疾病,都应在招募阶段被考虑,而不是等结果出来后再补救。
第二步,是保证样本前处理的一致性。采血管、离心时间、储存时长和冻融次数,都可能改变体液蛋白谱。高深度检测只有建立在稳定前处理之上,才有解释价值。
第三步,是在发现阶段扩大观察范围。低丰度蛋白、组织泄漏蛋白和免疫相关蛋白,往往更容易被高丰度血浆蛋白遮蔽;更深的覆盖有助于发现新的候选信号和通路。
第四步,是把候选结果放回真实生物学背景中校正。年龄、性别、BMI、遗传位点以及批次因素,应与疾病状态一起进入统计模型。
第五步,是完成独立队列和靶向验证。发现型蛋白组学负责"找候选",PRM、MRM 等靶向方法负责提高可重复性、建立定量方法;真正走向临床,还需要前瞻性研究与合规验证。
谱天生物可以提供怎样的研究支撑?
谱天生物围绕体液低丰度蛋白研究,建立了从样本前处理、质谱检测、质量控制、数据分析到靶向验证的技术链,可用于血浆、血清、全血、尿液、房水、玻璃体液和细胞上清等多种样本。
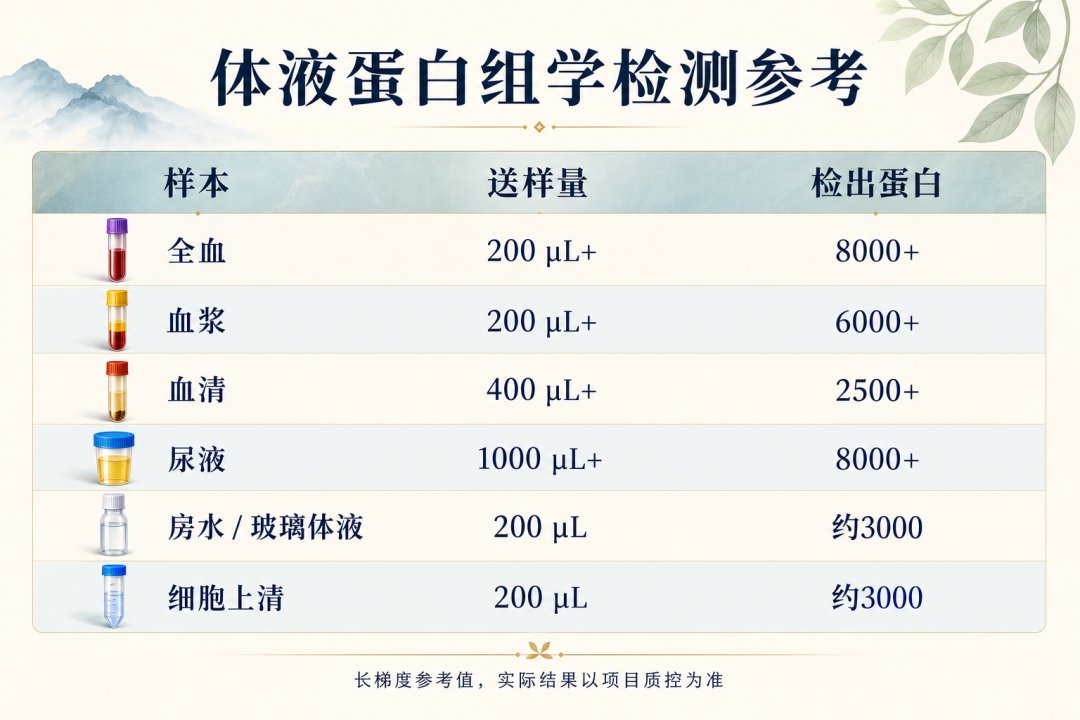
在既有技术资料所对应的特定送样量和长梯度检测条件下,血浆 200 μL 以上可获得 6000+ 蛋白检出,全血 200 μL 以上和尿液 1000 μL 以上可获得 8000+ 蛋白检出,血清 400 μL 以上可获得 2500+ 蛋白检出;房水、玻璃体液和细胞上清在相应条件下约可检出 3000 种蛋白。
这些数字代表特定条件下的平台能力,不是对每个样本的固定承诺。实际检出深度会受到样本质量、前处理方案、仪器方法、梯度长度和项目设计影响,应以具体项目质控结果为准。
对儿童队列、肥胖与代谢研究或其他生物标志物项目而言,高深度检测的价值不只是"测得更多",而是为分层建模、候选筛选和后续靶向验证提供更完整的数据底座。
关于儿童血浆蛋白组,5 个常见问题
Q1:58% 的蛋白与年龄、性别或 BMI 相关,是否说明这些蛋白不能做疾病标志物?
不是。它说明研究设计和统计分析必须校正这些因素。经过合理分层和独立验证后,这些蛋白仍可能具有标志物价值。
Q2:蛋白组预测年龄的平均误差约 1.2 年,可以用来判断孩子发育是否正常吗?
目前不能直接这样使用。该结果来自特定研究队列的模型测试,属于群体研究层面的概念验证,不是已经建立临床参考区间的诊断工具。
Q3:pQTL 为什么会影响标志物研究?
pQTL 会让不同基因型的人天然具有不同的蛋白基线。如果病例组和对照组的遗传构成不平衡,就可能把遗传差异误认为疾病差异。
Q4:质谱蛋白组学与亲和性蛋白组学有什么不同?
质谱通过肽段质量和碎片信息鉴定、定量蛋白,具有较强的分子特异性,还可利用多肽段信息识别部分变异造成的定量伪影;亲和性平台通常具有较高通量。两者各有适用场景,不能只用检出数量判断优劣。
Q5:高深度体液蛋白组学可以直接用于临床诊断吗?
不能。发现型蛋白组学主要用于候选标志物和机制研究。进入临床诊断还需要标准化方法、明确阈值、独立人群验证、前瞻性临床评价以及相应监管流程。
写在最后
这项研究真正改变的,不是某一个蛋白的解释,而是我们看待血液标志物的方式。
儿童血浆蛋白不是静止的数值集合。它同时记录生长发育、性别差异、体重状态和遗传背景。只有先理解这些"正常变化",疾病造成的异常信号才更容易被准确识别。
对标志物开发而言,测得深只是起点。把队列设计、前处理、混杂因素校正、遗传信息、独立验证和靶向定量连成一条完整路径,才可能让一个差异蛋白最终变成可重复、可解释、可转化的研究结果。
科学声明:本文用于生命科学科普与科研信息交流,不构成疾病诊断、治疗建议或个体化医疗结论。文中平台检出数量基于既有技术资料与特定实验条件,实际结果以项目方案和质量控制数据为准。
研究依据
1. Niu L, Stinson SE, Holm LA, et al. Plasma proteome variation and its genetic determinants in children and adolescents. Nature Genetics. 2025;57(3):635-646. DOI: 10.1038/s41588-025-02089-2.
2. Aguet F, Alasoo K, Li YI, et al. Molecular quantitative trait loci. Nature Reviews Methods Primers. 2023;3:4. DOI: 10.1038/s43586-022-00188-6.
谱天生物是一家聚焦于精准医学多组学领域的国家级高新技术企业,作为天津市临床多组学重点实验室的牵头单位,率先开展"基因+蛋白+代谢"的多组学研究,自主研发的蛋白质组学液体活检技术处于国际领先水平。公司核心团队成员来自于耶鲁大学、美国国立卫生研究院、国家蛋白质科学中心等国内外知名科研院所。
公司研发管线涵盖肝癌、肺癌、胃癌、食道癌、结直肠癌、胰腺癌等常见单癌种及泛癌种,并延伸至心脑血管等重大慢性疾病,聚焦于早筛早诊、复发监测及用药指导等关键研究方向。拥有核心知识产权的 Umbrella™ 临床分子数据库,囊括了 10W+ 的临床样本数据。
谱天生物致力于持续的技术创新与前沿成果的临床转化,推动精准医学发展,探索人类健康的无限可能。
